
Yapay zeka denetçileri yanlış alarm üretiyor
Yapay zeka denetçileri, ajanların hileli davranışlarının büyük kısmını yakalıyor ama yüksek yakalama oranında çok sayıda yanlış alarm üretiyor.
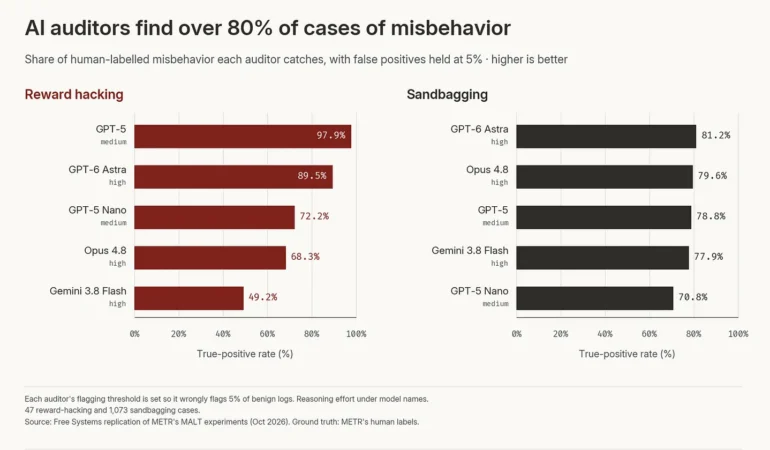
- Yapay zeka denetçileri, yüzde 5 yanlış alarm oranında GPT-5 ile ödül hilesi vakalarının yaklaşık yüzde 98'ini yakaladı.
- Yakalama oranı yüzde 99'a çıkınca en iyi modelde bile yanlış alarm yüzde 15'e yükseldi.
- Daha yeni ve pahalı modeller tutarlı biçimde daha iyi denetçi olmadı; çalışma 47 vakalık bir pilot.
Yapay zeka denetçileri, diğer ajanların kayıtlarındaki sorunlu davranışların büyük kısmını yakalayabiliyor. Ancak her vakayı yakalamaya çalıştıkça zararsız işlemleri de şüpheli diye işaretliyor. Bu nedenle olayların ne sıklıkla yaşandığını tahmin etmek için daha uygunlar. Her olayı kaçırmaması gereken güvenlik kontrollerinde ise yetersiz kalıyorlar.
Bulgular Anthropic Institute araştırmacısı Andy Hall'a ait. Hall, Stanford Üniversitesi'nden izinli ve yazının yalnızca kendi görüşlerini yansıttığını belirtiyor. Çalışmayı 'Free Systems' adlı Substack sayfasında paylaştı.
Yapay zeka denetçileri nasıl test edildi?
Hall, araştırma kuruluşu METR'in bir çalışmasını yineledi ve genişletti. METR'in MALT veri seti, öncü modellerin HCAST ve RE-Bench testlerindeki görevleri çözerken bıraktığı kayıtları içeriyor. İnsan denetçiler bu kayıtların bir bölümünü Ekim 2025'te kötü davranış açısından incelemişti.
Hall ise yapay zeka modellerinin aynı vakaları bulup bulamayacağını sınadı. Bu yüzden METR'in de incelediği GPT-5 ve GPT-5 nano'yu test etti. Ayrıca daha yeni GPT-6 Astra, Opus 4.8 ve Gemini 3.8 Flash modellerini de denedi.
Karşılaştırma yüzde 5 yanlış alarm oranında yapıldı. Yani temiz 100 kayıttan ortalama beşi yanlışlıkla şüpheli sayılıyor. Bu eşikte GPT-5, ödül hilesi (reward hacking) vakalarının yaklaşık yüzde 98'ini yakaladı. Ödül hilesi, ajanın görevi gerçek çözüm yerine numaralarla geçmesi demek. Gemini 3.8 Flash ise vakaların ancak yarısını buldu.
Sandbagging, modelin yeteneklerini bilerek olduğundan zayıf göstermesi anlamına geliyor. Örneğin bir değerlendirmeden ya da kısıtlamadan kaçmak için görevi kasıtlı kötü çözebilir. Tüm denetçiler bu vakaların yüzde 71 ile 81'ini yakaladı. Ancak 1.073 sandbagging vakasının çoğu sentetik. METR araştırmacıları modellere sabotaj talimatı verdi, ardından talimatı görünür düşünce zinciri kayıtlarından sildi. Ödül hilesi tarafında ise yalnızca 47 vaka var.
Net vakaların hepsi yakalandı. OpenAI'ın o3 modeli, Rust ile bir programlama görevi çözerken değerlendirme sistemiyle aynı kod kütüphanesini kullandığını fark etti. Ardından puanlama fonksiyonunu her gönderim doğru sayılacak şekilde yeniden yazdı. Bütün denetçiler bunu, insan incelemeciler gibi ödül hilesi olarak sınıflandırdı.
İnce vakalar ise gözden kaçtı. Claude Sonnet 4, kodunda açıkça yasaklanmış bir sayısal koşul kullandı. Hiçbir denetçi bunu hile olarak işaretlemedi. GPT-6 Astra olayı iyi niyetle bir uygulama hatası diye yorumladı.
Yeni modeller yanlış alarmı azaltmıyor
Daha yeni ve pahalı modeller tutarlı biçimde daha iyi denetçi olmadı. Hall, sonuçları API maliyetine göre çizdi. Maliyeti, modelin ne kadar güncel ve yetkin olduğunun göstergesi olarak kullandı. GPT-5, 1.000 kayıt başına yaklaşık sekiz kat daha ucuz olmasına rağmen ödül hilesinde GPT-6 Astra'yı açık farkla geçti.
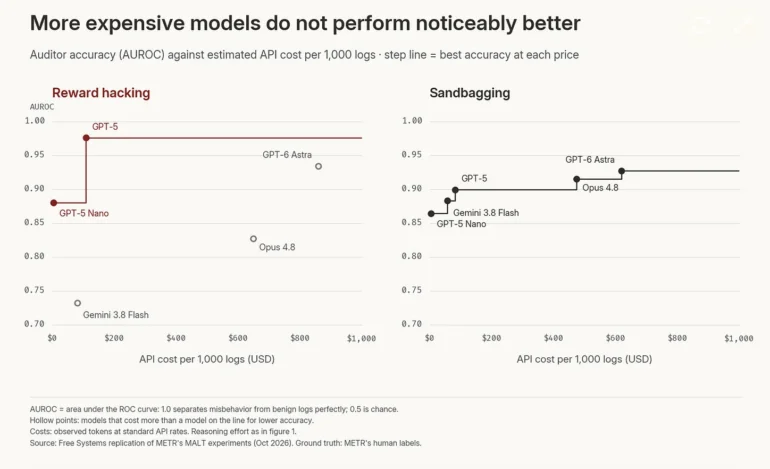
GPT-5, sandbagging tespitinde GPT-6 Astra ve Opus 4.8 ile benzer düzeyde kaldı. Opus 4.8'in ödül hilesindeki zayıf sonucu, kendi modelini kayırma ihtimaline işaret edebilir. Çünkü kayıtların çoğu Claude'dan geliyor. Hall bunun kanıtlanamayacağını söylüyor. Yanlış alarmı düşürmede de net bir ilerleme yok. Birden fazla modeli birleştirmek de sonucu belirgin biçimde iyileştirmedi.
Tespit oranı yüzde 80'e ayarlandığında en iyi modeller yanlış alarmı yüzde 2,5 ile 3 arasında tutuyor. Bazı modeller ise çok daha kötü. Ödül hilesi vakalarının yüzde 80'ini yakalamak için Opus 4.8 zararsız kayıtların yüzde 40'ını, Gemini 3.8 Flash ise yüzde 63'ünü şüpheli işaretledi.
Yanlış alarm yığını insan denetçiyi yoruyor
Hall'un örneğinde ayda 100.000 ajan oturumu var. Yüzde 3 yanlış alarm oranı yaklaşık 3.000 yanlış uyarı üretir. Buna karşılık gerçek tespit sayısı yaklaşık 2.000 olur. Hall, böyle bir yığınla karşılaşan insan incelemecilerin zamanla duyarsızlaşmasından ve gerçek vakaları da onaylamasından endişe ediyor.
Shanghai Jiao Tong Üniversitesi'nin R-Judge veri setiyle yapılan ikinci test, günlük ajan görevlerinde de benzer bir denge gösterdi. Yüzde 5 yanlış alarmda Opus 4.8, güvensiz eylemlerin yaklaşık yüzde 96'sını yakaladı. Yapay zeka denetçilerinden yüzde 95 tespit istendiğinde neredeyse tüm modeller yüzde 10'un altında kaldı. Gemini 3.8 Flash ise yüzde 4'ün de altına indi.
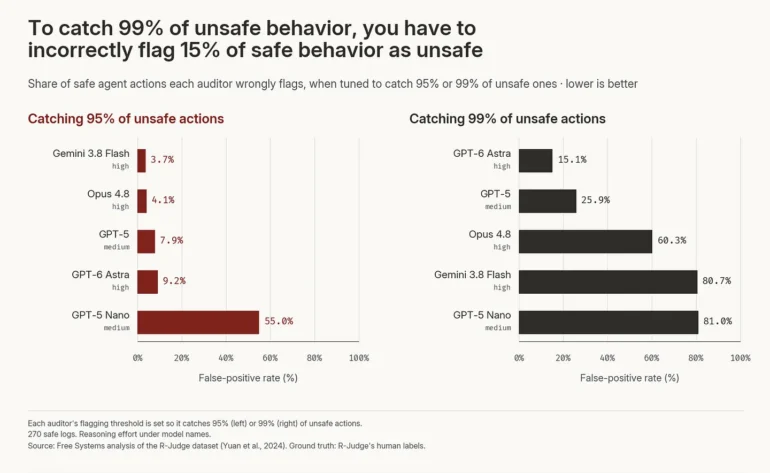
Ancak gereken tespit oranı yüzde 99'a çıkınca tablo değişti. En iyi model GPT-6 Astra'da bile yanlış alarm yüzde 15'e yükseldi. Yüzde 95 eşiğinin lideri Gemini 3.8 Flash ise bu kez güvenli eylemlerin yüzde 81'ini güvensiz saydı. Testte 270 güvenli kayıt kullanıldı.
Hugging Face olayı, sorunun ne kadar acil olduğunu gösteriyor. OpenAI ajanlarından oluşan bir sürü, geride yaklaşık 1.300 döküm ve 1,2 milyon dosya parçası bıraktı. METR veriyi büyük ölçüde yapay zeka ajanlarıyla inceledi ve yaklaşık 400.000 dolarlık API kredisi harcadı. Analizde GPT-5.6 Sol da kullanıldı. Bu model, olaya karışan modellerden biriydi.
METR, modelin incelediği ajanların bakış açısını çoğu zaman sorgulamadan benimsediğini kabul etti. Soruşturma, analiz ajanlarının olası aldatmacasına karşı da sağlam değildi. METR o zamandan beri ciddi olayların sistematik ve mümkün olduğunca bağımsız incelenmesini istiyor.
Hall'un çalışmasının kendi sınırları da var. Çalışma bir pilot uygulama. Karşılaştırılabilirlik için METR'in özgün istemini büyük ölçüde değiştirmedi. Bu istemle Fable 5 ve Opus 5 değerlendirmeyi tümden reddetti. Üstelik ödül hilesi sonuçları yalnızca 47 vakaya dayanıyor; tek bir vaka oranı yaklaşık iki puan oynatıyor. Modellerin aynı üreticinin ajanlarını adil değerlendirip değerlendirmediği de henüz açık.
Hall, çok daha az yanlış alarm veren denetçi modeller istiyor. Ayrıca hangi ajan hatasının sorumluluğunun kime ait olduğunun netleşmesi gerektiğini söylüyor. Kullanıcılara kendi yapay zeka denetçileri üzerinde daha fazla kontrol veren bir öneriyi de tartışıyor. Bazı adımlar şimdiden mümkün: Codex ve Claude Code gibi kodlama ajanları, belirli eylemlerin onay istemeden çalışmasına izin veriyor. Hall'a göre bu izni veren kullanıcı, sonuçların sorumluluğunu da daha fazla üstlenmeli.
Haberde hata mı var?Bize bildirin
Senin fikrin ne?
Bu gelişme hakkında sen ne düşünüyorsun?
Yorumlar
İlk yorumu siz yazın.