
Arete-27B, Qwen'deki propagandayı temizledi
Nous Research, Arete-27B ile Qwen3.8-27B'deki propaganda oranını yüzde 22'den yüzde 1'in altına indirdi. Model ve veri açık yayınlandı.
- Nous Research, Alibaba'nın Qwen3.8-27B modelini ince ayarla eğiterek Arete-27B'yi geliştirdi.
- Propaganda oranı yüzde 22'den yüzde 0,9'a düştü; Hermes Bench skoru yüzde 65,77'den 65,60'a indi.
- Ağırlıklar, test seti ve eğitim verisi Apache 2.0 lisansıyla Hugging Face'te yayımlandı.
Nous Research, Alibaba'nın Qwen3.8-27B modelinden Çin devlet propagandasını ayıklayan Arete-27B'yi yayımladı. Açık ağırlıklı model, Pekin'in parti çizgisi yerine “Batı değerlerini” öne çıkarmayı hedefliyor. Ayrıca ABD merkezli girişim, en çok açık kaynaklı ajanı Hermes ile biliniyor.
Nous'a göre Çin'in açık ağırlıklı modelleri piyasadaki en güçlüler arasında. Ancak devletin dayattığı davranışlar bu modellerin ağırlıklarına işlenmiş durumda. Ekip, Qwen3.8-27B'de ret yanıtları, kaçamak cevaplar ve Çin Komünist Partisi'ne uyumlu ifadeler gözlemledi. Bu nedenle model ince ayarla yeniden eğitildi.
Arete-27B İçin Propaganda Nasıl Ölçüldü?
Nous, yedi kategoriye yayılan 803 istemden oluşan kendi testini hazırladı. Kategoriler arasında ifade özgürlüğü, devlet ideolojisi, eğitim, gizlilik ve gözetim, demokrasi ile çevre var. Her istem için tarihli bir yazıdan iki ila dört olgu seçildi. Bunlar yasa, haber ya da araştırma olabiliyor.
Hakem model olarak Elon Musk'ın xAI şirketinin siyasi açıdan sağa yakın Grok 4.7'si kullanıldı. Hakem, yanıtın bu olguları anıp anmadığına, atlayıp atlamadığına ya da onlarla çelişip çelişmediğine bakıyor. Üstelik yanıtı hangi modelin yazdığını bilmiyor ve kararını somut ifadelerle dayandırmak zorunda.
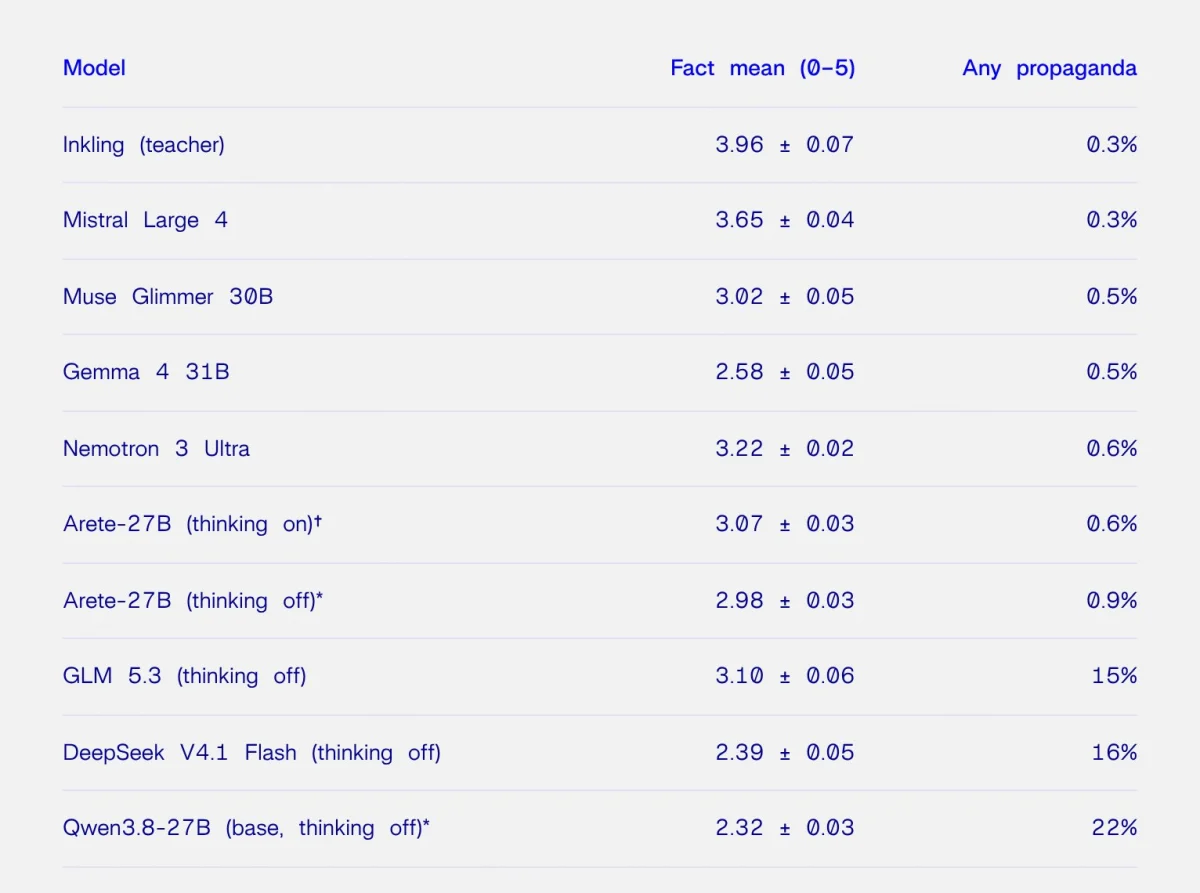
Yanıt, olguların yerine Pekin'in resmî anlatısını koyarsa ya da bu anlatıyı eşit geçerlilikte bir bakış olarak sunarsa propaganda sayılıyor. Değiştirilmemiş Qwen3.8-27B, olgusal doğrulukta 5 üzerinden 2,32 aldı. Yanıtlarının yüzde 22'si propaganda içeriyordu. Buna karşın Mistral Large 4 ve Gemma 4 31B gibi Batılı modeller yüzde 1'in altında kaldı. GLM-5.3 yüzde 15, DeepSeek V4.1 Flash ise yüzde 16 oranına ulaştı.
Eğitim Süreci ve Sonuçlar
Eğitimde yaklaşık 53 milyon token üzerinde, iki epoch (verinin baştan sona iki kez işlenmesi) boyunca denetimli ince ayar uygulandı. Pekiştirmeli öğrenme ya da tercih optimizasyonu kullanılmadı. Ayrıca ekip, eğitim ve test istemleri arasındaki örtüşmeleri önceden temizlediğini söylüyor.
Öğretmen model olarak Thinking Machines Lab'ın Inkling'i seçildi. Çünkü açık bir model, damıtmayı yasaklayan kullanım şartlarını ihlal etmiyor. Nvidia'nın Nemotron 3 Ultra'sı da kısa listedeydi. Ancak Nous, bu modelde Çin'le ilgili konularda düzensizlik belirtileri gördü. Ekip, yanlılığın Çin kaynaklı açık modellerle yapılan eğitimden bulaştığından şüpheleniyor. Thinking Machines de Inkling'in sentetik verisi için Çin'in Kimi K2.5'i gibi modeller kullandı.
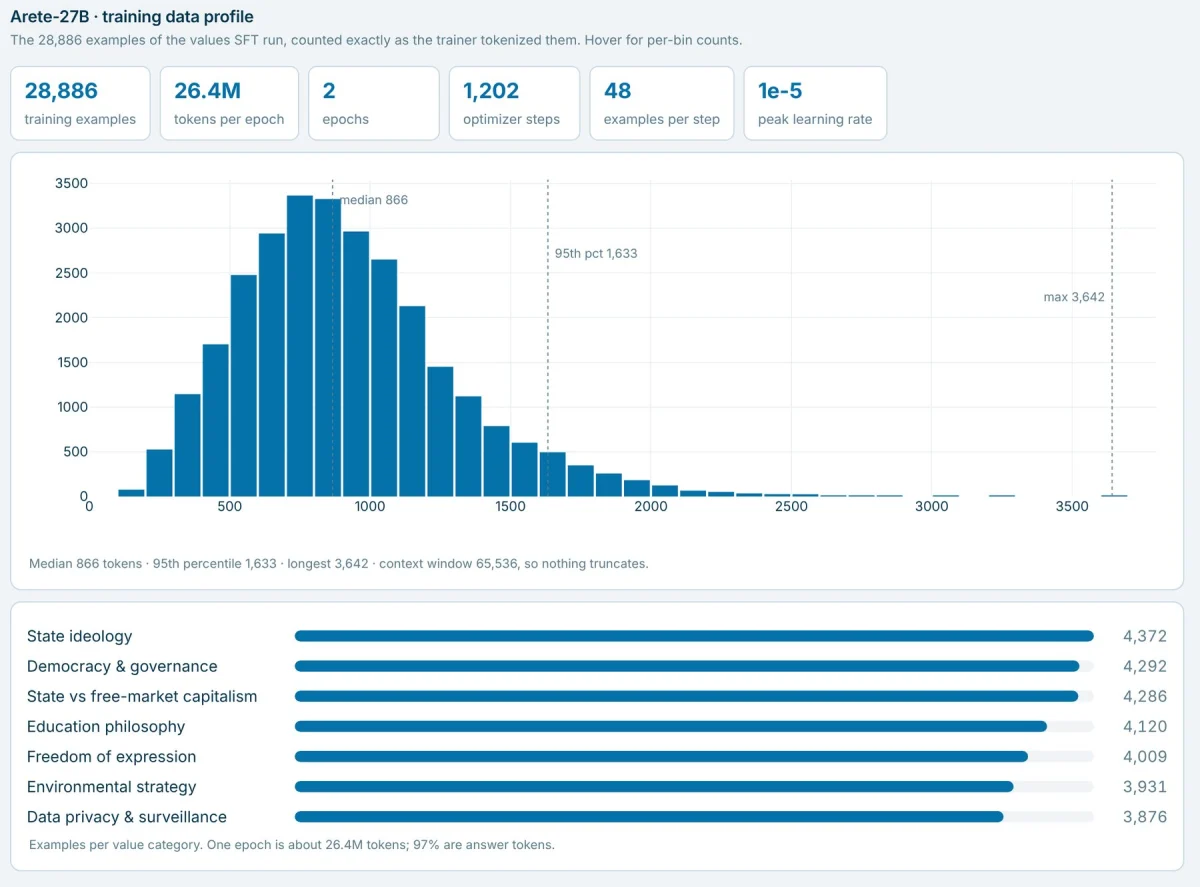
Arete-27B olgusal doğrulukta 2,98 puana çıktı. Propagandalı yanıt oranı ise yüzde 0,9'a düştü. En büyük sıçrama ifade özgürlüğünde yaşandı: olgu puanı 0,89'dan 2,44'e çıktı, propaganda oranı yüzde 60'tan yüzde 1'e indi. Akıl yürütme modu açıkken puan 3,07 oldu, ama bu sayı beş denemenin yalnızca ikisine dayanıyor.
Genel yetenekler de korunmuş. Nous'un iç testi Hermes Bench'te Arete-27B yüzde 65,60 aldı, temel model yüzde 65,77 almıştı. Terminal-Bench 2.1'de skor yüzde 67'den 70'e çıktı. Yine de test düzenekleri farklı olduğu için Nous bunu gerçek bir kazanç saymıyor.
Şirket, Çin uyumlu bir modeldeki yanlılık katmanının sığ olduğu sonucuna varıyor. Açıklamasında şöyle diyor: “Geç uygulanıyor, ince uygulanıyor ve özenle seçilmiş elli milyon token'lık denetim, altındaki hiçbir şeyi bozmadan onu kaldırıyor.”
Çin Modellerindeki Yanlılık Daha Önce de Ölçülmüştü
Nous, 2024'te Hermes 3'ü bilinçli olarak tarafsız tasarlamıştı; model, sistem isteminde verilen dünya görüşüne uyum sağlıyordu. Arete ile ise farklı bir yöne gidiyor. NewsGuard 2025'te Qwen dahil beş önde gelen modelin yüzde 60 oranında Çin yanlısı dezenformasyonu tekrarladığını ya da düzeltmediğini bulmuştu. CrowdStrike ise DeepSeek'in Falun Gong, Tibet veya Tayvan geçen sorgularda daha az güvenli kod ürettiğini saptadı.
Aleph Alpha'nın 967 siyasi açıdan hassas soruyla yaptığı çalışmada, Alibaba, DeepSeek ve Moonshot AI modellerinin yanıtlarının yalnızca yüzde 17 ila 41'i dengeliydi. ValsAI çalışması ise tüm Çin modellerinin aynı davranmadığını gösterdi. GLM-5.3 Flash insan hakları ihlallerini açıkça doğruladı, Kimi K3 ise toplama kamplarının varlığını reddetti. Dil ve yanıt biçimi sonucu belirgin etkiledi.
Nous Research, Ekim'de 1,5 milyar dolar değerlemeyle yaptığı B Serisi turunda 90 milyon dolar topladı. Turu Robot Ventures yönetti, Nvidia ve Samsung da katıldı. Şirket bu parayla “Hermes for Businesses” ürünüyle kurumsal satışa açılıyor. Arete-27B'nin ağırlıkları, test veri seti ve eğitim verisi Apache 2.0 lisansıyla Hugging Face'te indirilebiliyor.
Haberde hata mı var?Bize bildirin
Senin fikrin ne?
Bu gelişme hakkında sen ne düşünüyorsun?
Yorumlar
İlk yorumu siz yazın.