
Co-Design Bench'te en iyi skor yalnızca %26,4
Co-Design Bench testinde GPT-6 Astra, gerçek kullanıcı taleplerinden oluşan görevlerin yalnızca yüzde 26,4'ünü tamamen doğru çözdü.
- Alibaba ve Asyalı üniversiteler, gerçek kullanıcı taleplerinden oluşan Co-Design Bench kodlama testini geliştirdi.
- En iyi model GPT-6 Astra, görevlerin yalnızca yüzde 26,4'ünü tamamen doğru çözdü.
- Aynı model farklı çalışma ortamlarında farklı puan alıyor; Qwen3.8-27B yüzde 75 ile yüzde 56 arasında değişti.
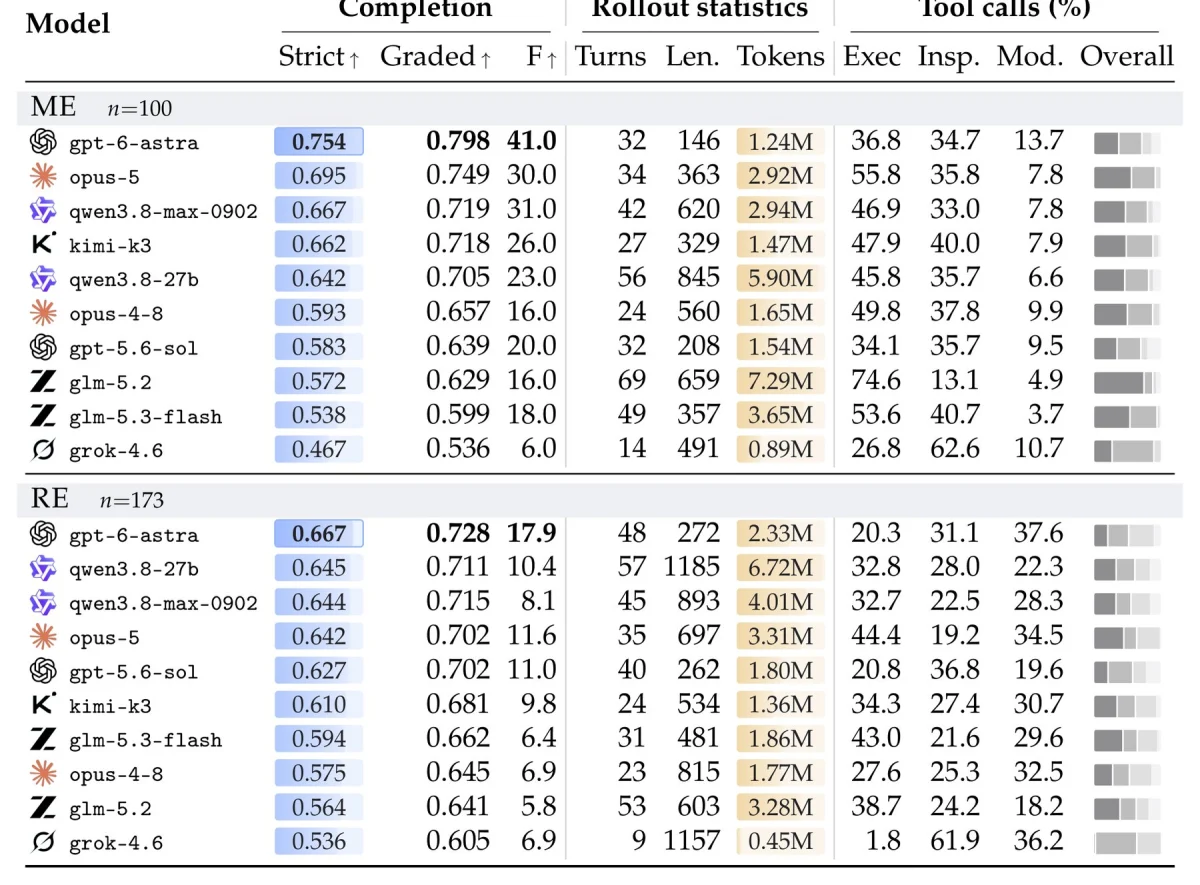
Alibaba ve birkaç Asyalı üniversiteden araştırmacılar, kodlama ajanlarını gerçek kullanıcı taleplerine göre sınayan Co-Design Bench testini geliştirdi. On modelin denendiği testte lider GPT-6 Astra, bir görevin gereksinimlerinin ortalama yüzde 70'ini karşıladı. Ancak sonucun tamamen doğru olduğu görev oranı yalnızca yüzde 26,4'te kaldı.
Test, mevcut web uygulamalarını kullanıcı taleplerine göre yeniden düzenlemeyi gerektiriyor. Bazı görevlerde girdi olarak görsel, ses kaydı, video ya da belge veriliyor. Ajanlar çoğu durumda işin büyük kısmını hallediyor ama en az bir ayrıntıyı eksik bırakıyor. Bu yüzden kullanıcı neredeyse her seferinde elle düzeltme yapıyor.
Co-Design Bench Neden Eski Testlerden Farklı?
Araştırmacılar yeni testi, mevcut ölçütlerin doygunluğa ulaşmasıyla gerekçelendiriyor. Çünkü modeller kendi kodlarını çalıştırıp denetleyebildiğinde bu testlerde yüzde 99'un üzerinde puan alıyor. Dolayısıyla modeller arasındaki fark neredeyse ölçülemiyor. Örneğin WebCompass-edit gibi eski testlerde ajan odaklı modeller neredeyse kusursuz sonuç veriyor. Buna karşın Co-Design Bench'te aradaki fark 35 puanı aşıyor.
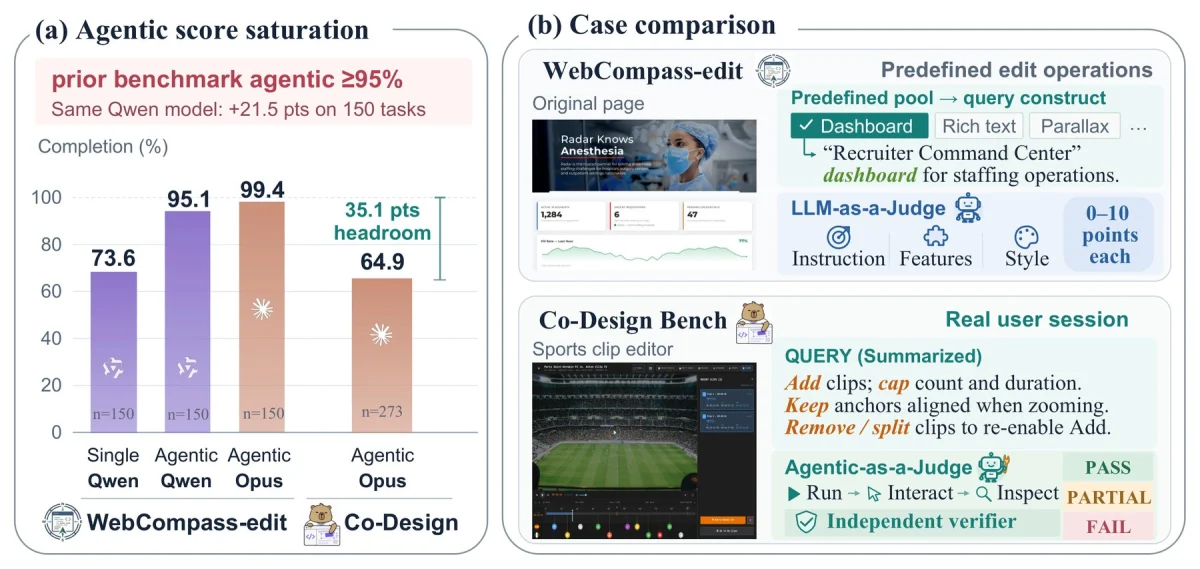
Co-Design Bench, gerçek kodlama oturumlarındaki taleplerden besleniyor. Araştırmacılar, kullanıcının isteğini birkaç kez yeniden yazdığı ya da değişiklikleri geri aldığı örnekleri özellikle seçti. Böylece testte ağırlıklı olarak pratikte ajanları zaten zorlamış görevler yer alıyor. Örneğin bir fişten tutarı çekip bağlı tüm toplamları güncellemek gibi küçük işler var. Bunun yanı sıra projenin tamamını elden geçirmek gibi büyük görevler de bulunuyor.
Çok kipli (multimodal) kolda ajanlar fişlerden, tablolardan ya da videolardan değer çıkarıyor. Ardından bu değerlere bağlı tüm görünümleri tutarlı biçimde güncellemeleri gerekiyor.
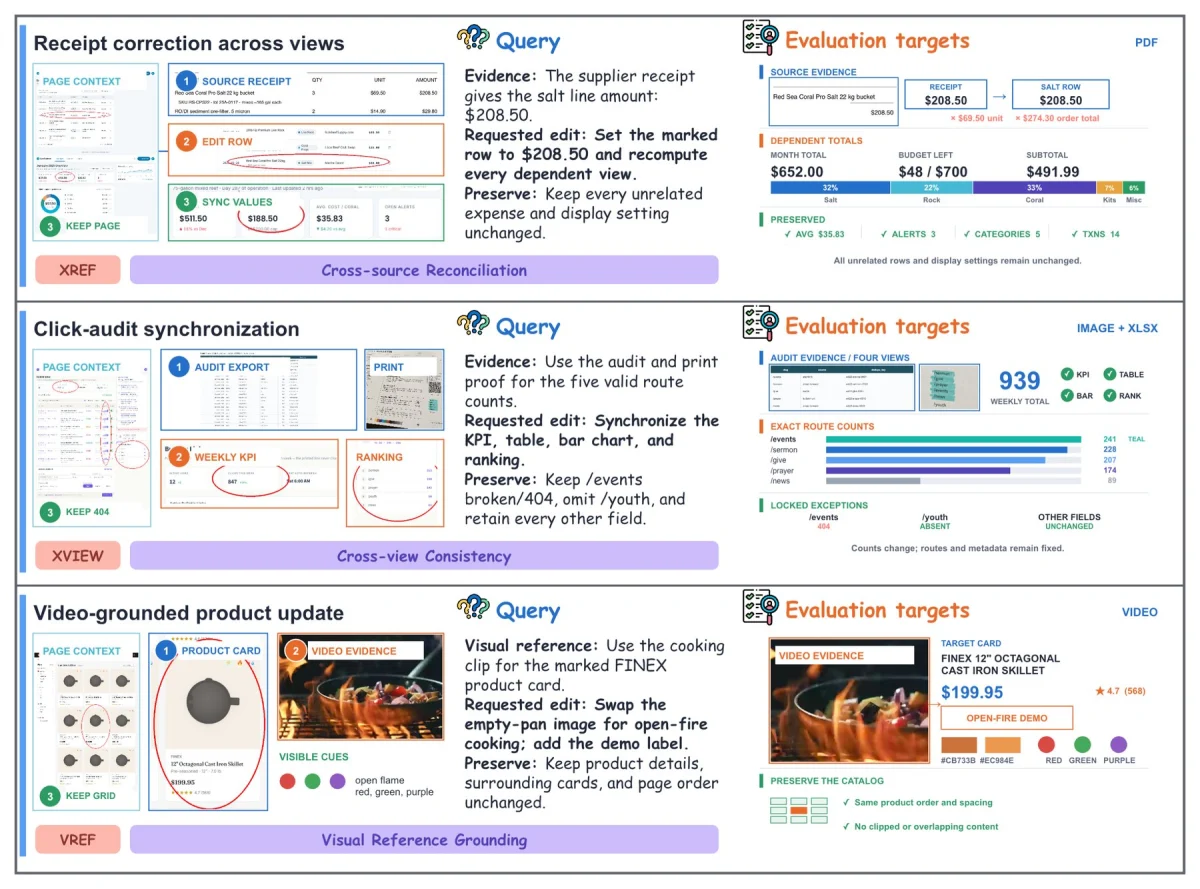
Puanlama da aynı ölçüde sıkı. Öncelikle bir yapay zeka hakemi bitmiş uygulamayı tarayıcıda deniyor. Ardından ikinci bir hakem olumlu her kararı yeniden kontrol ediyor ve sahte arayüz ya da sabit yazılmış sonuç arıyor. Puan yalnızca uygulamada gerçekten çalışan özelliklere veriliyor.
Birden Fazla Değişiklik Türü Modelleri Zorluyor
Sıralamada GPT-6 Astra'nın ardından Claude Opus 5 ve Qwen3.8-Max geliyor. Grok 4.6 ise son sırada yer alıyor. Daha büyük elden geçirmelerde çok daha küçük Qwen3.8-27B ikinci sıraya çıkıyor. Yine de araştırmacılar bu sonuçtan modelin genel bir üstünlüğü olduğunu çıkarmıyor.
Yerleşim, tasarım, etkileşim ve içerik gibi değişiklik türleri bir görevde birleştikçe tüm modellerin performansı düşüyor. Oysa gerçek projelerde bu iç içe talepler istisna değil, kuraldır.
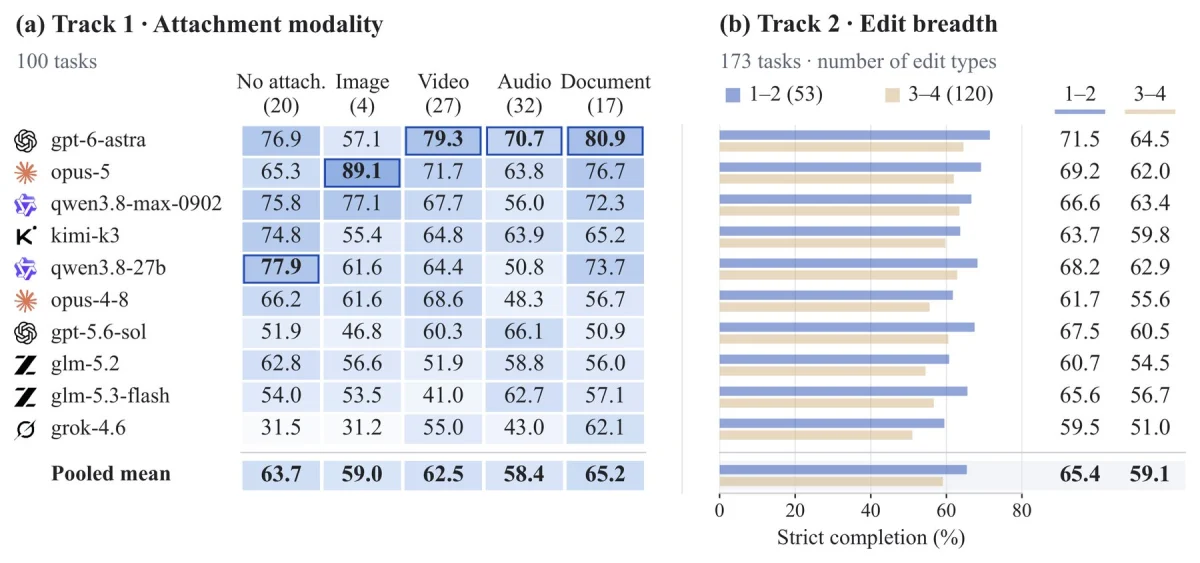
Ek işlem gücü bu zayıflığı pek gidermiyor. Örneğin GLM-5.2, küçük değişikliklerde GPT-6 Astra'nın yaklaşık altı katı token harcıyor. Buna karşın belirgin biçimde daha düşük puan alıyor.
GPT-6 Astra her iki kolda da önde. Ancak çok kipli görevlerin yalnızca yüzde 41'ini tam çözebiliyor. Depo (repository) görevlerinde ise oran yüzde 18'in biraz altında kalıyor.
Çalışma Ortamı da En Az Model Kadar Belirleyici
Araştırmacılar aynı modelleri farklı çalışma ortamlarında da denedi. Bu ortamlar, ajanın kodu okuduğu, yazdığı ve çalıştırdığı programlardan oluşuyor. Örneğin Qwen3.8-27B, büyük elden geçirmelerde ortama göre yüzde 75 ya da yalnızca yüzde 56 puan aldı. Üstelik iki modelden hangisinin öne çıktığı da ortama göre değişti.
Bu nedenle yalnızca modeli listeleyen sıralamalar tablonun bir kısmını gösteriyor. Yazarlar model ve çalışma ortamının birlikte raporlanmasını öneriyor. Dolayısıyla kodlama ajanı seçecek şirketlerin iki bileşeni çift olarak test etmesi gerekiyor.
Testin sınırları da var. Her görevde tek ve sabit bir talep değerlendiriliyor; kullanıcının ek soruları ya da görev sırasındaki düzeltmeleri kapsam dışında. Ayrıca yapay zeka hakemleri de hata yapabiliyor.
Araştırma kuruluşu METR'in çalışması, kıyaslama sonuçlarıyla gerçek kullanılabilirlik arasındaki farkı daha önce de göstermişti. Buna göre proje sorumlularının yapay zeka kodunu kabul oranı, SWE-bench Verified puanlarının yaklaşık 24 puan altında kaldı. Test ortamlarındaki kusurlar da ajanların görevleri çözmeden geçmesine yol açabiliyor.
Öte yandan ortamın etkisi tek yönlü değil. Yakın tarihli çalışmada daha ayrıntılı çalışma ortamları üç kata kadar fazla token tüketmesine rağmen neredeyse hiç ölçülebilir fayda sağlamadı.
Haberde hata mı var?Bize bildirin
Senin fikrin ne?
Bu gelişme hakkında sen ne düşünüyorsun?
Yorumlar
İlk yorumu siz yazın.